
Fréquence d'indexation Google : ce qu'il faut savoir en 2026
Si vos meilleurs articles restent en orbite sans jamais percer, ce n'est pas (que) votre contenu : c'est probablement la fréquence à laquelle Google revient vous crawler. En 2026, la fréquence crawl Google sur un blog dépend moins d'une « règle du jeu » chiffrée que d'un mélange de signaux techniques, de popularité de page et de santé globale du domaine.
Ce guide rassemble ce que la Search Console montre réellement, ce qui fait chuter le rythme de revisite, et les leviers concrets pour le faire remonter sans déclencher de signal spam.
Sommaire
- Points clés
- Fréquence d'indexation Google : quelle réalité en 2026 ?
- Comment lire le budget crawl dans la Search Console
- Quels signaux font chuter la fréquence d'indexation ?
- Comment augmenter la fréquence sans tomber dans le spam
- Mesurer l'effet d'un changement sur l'indexation
- Questions fréquentes
- Sources
Points clés
- La fréquence à laquelle Google revisite un blog n'est jamais publiée par Google : elle se déduit du croisement entre le rapport Statistiques d'exploration et les logs serveur.
- En 2026, le plafond réaliste pour un blog d'entreprise tourne autour de quelques requêtes par seconde lors des pics, et tombe à quelques requêtes par jour sur les URL profondes peu demandées.
- Les facteurs qui pèsent le plus : vitesse de réponse, sitemap propre, canoniques cohérentes, maillage interne, popularité de la page et signaux « spam signals » négatifs (paramètres, duplicate, soft 404).
- Modifier un réglage sans mesurer avant/après ne sert à rien : un changement se juge sur 14 à 28 jours d'observation.
- Tout pilotage sérieux passe par la Search Console — pas par des suppositions sur un chiffre mythique que personne ne publie.
Fréquence d'indexation Google : quelle réalité en 2026 ?
En 2026, Google ne communique toujours pas de chiffre officiel de « fréquence crawl Google » applicable à tous les sites. Ce qu'il publie, ce sont des principes : un budget d'exploration alloué par site, pas par page, et qui dépend à la fois de la taille perçue du site, de la santé technique du domaine et de la demande qu'il observe pour vos URL.
En pratique, un blog d'entreprise reçoit l'essentiel de ses visites du robot sur quelques URL phares, et beaucoup moins — parfois quelques passages par mois seulement — sur les pages profondes que personne ne lie.
La conséquence directe, c'est qu'on ne peut pas raisonner article par article. On raisonne à deux niveaux :
- ce que Google veut explorer (la demande, c'est-à-dire les requêtes pour lesquelles il existe des impressions dans la Search Console) ;
- ce qu'il peut explorer sans surcharger le serveur (le budget technique).
Tant que ces deux variables s'alignent, la fréquence d'indexation Google 2026 reste suffisante. Quand elles divergent, certains articles restent connus mais jamais revisités après leur crawl initial.
Quand on observe un blog B2B, le déséquilibre classique est un sitemap de 600 URL crawlées une fois à la publication, puis oubliées pendant des semaines. C'est exactement ce profil qui donne l'impression de « rester en orbite ».
Comment lire le budget crawl dans la Search Console
Le budget crawl d'un blog d'entreprise se lit dans deux endroits complémentaires : le rapport Statistiques d'exploration de la Search Console, et les logs serveur.
Le rapport Search Console affiche des agrégats par jour (demandes, taille moyenne, temps de réponse, codes HTTP). Les logs montrent, requête par requête, quel User-Agent — Googlebot, Googlebot Smartphone, ou les robots d'images — a frappé quelle URL, à quel moment, et avec quel code retourné.
Les deux se lisent ensemble : la Search Console donne la tendance, les logs révèlent l'arbitrage entre familles de pages.
Pour repérer un budget sous pression, trois indicateurs suffisent :
- Temps de réponse médian : s'il dépasse 500 ms sur plusieurs jours consécutifs, Google baisse le rythme pour ne pas pénaliser l'expérience utilisateur.
- Écart sitemap vs exploration : quand l'écart dépasse 10 à 15 % du total déclaré, Google laisse de côté une part significative des URL détectées.
Ce triptyque se stabilise avant qu'on aille toucher au reste du site, et c'est aussi ce qu'on observe dans les audits éditoriaux les plus rigoureux.
Combien de fois Google passe-t-il réellement sur un blog ?
Aucun chiffre universel ne s'applique. Pour un blog d'entreprise standard, l'observation empirique — et non un seuil officiel — donne, en 2026, quelques requêtes par seconde lors des pics sur la page d'accueil et les piliers, et entre quelques requêtes par jour et une seule requête par semaine sur les longues traînes profondes.
Cette « crawl rate blog SEO » très inégale est normale : Google concentre ses efforts là où la demande est la plus forte.
Quels signaux font chuter la fréquence d'indexation ?
Les signaux qui font chuter la fréquence d'exploration se répartissent en quatre familles.
- Famille technique : temps de réponse élevé, disponibilité erratique, et tout ce qui multiplie les codes 5xx est immédiatement sanctionné.
- Famille de maillage : un blog sans liens internes clairs force Google à découvrir les pages par le sitemap, ce qui est plus lent qu'un parcours de liens. Une page à plus de trois clics de la home, sans aucun lien entrant interne, sera revisitée bien moins souvent.
- Famille de canonisation : URL canoniques incohérentes, paramètres de session crawlables, ou variantes trailing-slash créent des boucles où Google se perd.
- Famille spam signals : duplicate content massif, texte généré automatiquement sans valeur ajoutée, et backlink schemes détectées.
L'erreur la plus courante sur les blogs SEO reste le site mal adapté à un cycle de publication soutenue : un blog qui publie un article par jour mais qui ne propose aucun lien interne de fond entre eux donne à Google l'impression que chaque nouvelle page est un îlot.
Résultat : il les crawle, les indexe, et ne revient pas les consolider, parce qu'aucun signal ne lui indique qu'elles valent la peine.
Quels signaux sont vraiment sous-estimés ?
Trois signaux passent sous le radar des audits classiques.
- Redirections 302 : utilisées là où il faudrait des 301, Google continue à crawler l'URL source, ce qui dilue le budget.
- Sitemaps massifs sans lastmod cohérent : quand ils dépassent plusieurs dizaines de milliers d'URL, Google les traite avec prudence et n'en crawl qu'une fraction à chaque passage.
- Flux RSS et pages de catégories vides : ils créent un signal de faible qualité que Google apprend à ignorer.
Comment augmenter la fréquence sans tomber dans le spam
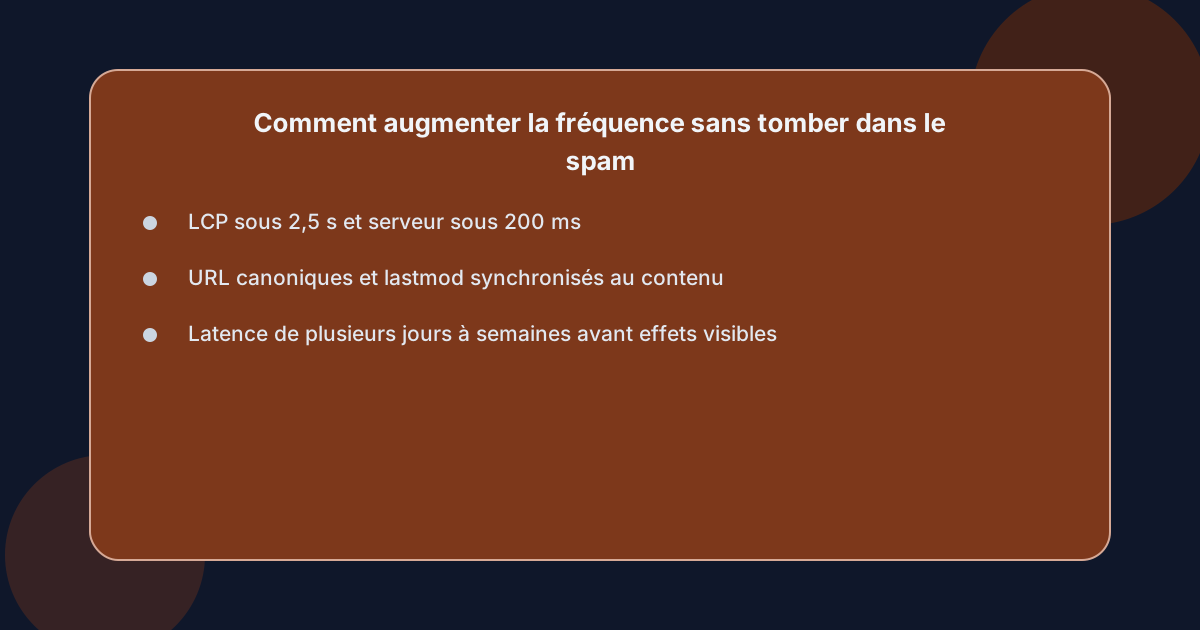 Augmenter le crawl sans tomber dans le spam consiste à aligner trois leviers, dans cet ordre.
- Premier levier — performance technique : viser un Largest Contentful Paint sous 2,5 secondes et un temps de réponse serveur médian sous 200 ms. Sous ces seuils, Google augmente mécaniquement la cadence.
- Second levier — cohérence du sitemap : ne lister que des URL canoniques, avec des dates lastmod honnêtement synchronisées au contenu réel, et divisé en sous-sitemaps thématiques si le blog dépasse 10 000 URL.
- Troisième levier — demande de page : plus une page reçoit de liens externes, de partages et de trafic direct, plus Google la crawle souvent. Pour un blog d'entreprise, ça passe par un travail de fond sur les pages piliers, pas par des astuces.
Trois règles simples complètent le dispositif :
- Ne jamais modifier massivement les URL : chaque modification fait repartir la courbe d'apprentissage.
- Ne pas abuser des flux RSS ni des pages tag à faible contenu : Google les explore quand même, et gaspille votre budget.
- Accepter que tout changement prend du temps : la Search Console documentation officielle parle d'une latence de plusieurs jours, voire quelques semaines, entre la modification et l'effet mesurable.
Qui fait réellement ce travail au quotidien ?
Dans la pratique, surveiller les logs, ajuster un sitemap, vérifier les canoniques et relancer la cadence demande soit un profil technique à temps plein, soit une équipe externalisée qui le fait pour plusieurs sites.
C'est précisément le type de tâche répétitive et mesurable que les outils d'édition automatisée commencent à internaliser. À condition qu'ils s'intègrent par publication directe sur le domaine du client, et qu'ils ne remplacent pas la relecture humaine, ils dégagent du temps que les équipes marketing passent ensuite sur les contenus piliers.
Pour les blogs qui dépassent quelques dizaines d'articles, le coût d'un pipeline éditorial automatisé publiant chaque jour reste nettement inférieur à la somme rédacteur + SEO technique + devops. Ceux qui veulent vérifier si cette mécanique tient pour leur site peuvent tester leur domaine pendant trois jours, sans carte bancaire.
Mesurer l'effet d'un changement sur l'indexation
Mesurer un changement sur l'indexation exige une méthode rigoureuse, sinon les conclusions sont inutilisables. La méthode tient en quatre étapes.
- Étape un — instant de référence : figer 14 à 28 jours, avec la moyenne des requêtes Googlebot par jour, la moyenne du temps de réponse médian, et la couverture d'index par groupe de pages.
- Étape deux — un seul paramètre : ne modifier qu'un réglage à la fois — par exemple, la compression des images, jamais la canonisation et les images ensemble.
- Étape trois — observation longue : observer 28 jours pleins, jamais moins, parce que la Search Console lisse ses données sur plusieurs jours.
- Étape quatre — comparaison : refaire la moyenne sur les 14 jours qui suivent et la comparer à la référence, en gardant deux chiffres : l'écart absolu, et l'écart en pourcentage.
L'erreur la plus coûteuse, c'est de confondre la fréquence crawl et le rang. Crawler plus souvent ne signifie pas monter dans les SERP : la fréquence de revisite ne sert qu'à accélérer la prise en compte d'un changement de contenu, pas à modifier la position.
Quand un test se solde par un crawl en hausse sans hausse de visibilité, c'est en général que la demande pour la page reste faible — et c'est le brief, pas l'indexation, qu'il faut retravailler. Pour un article qui commence à générer du trafic après indexation, c'est la demande de page qui fait la différence.
Questions fréquentes
Pourquoi Google arrête-t-il de crawler un blog qui publiait régulièrement ?
Google réduit la cadence quand la valeur perçue baisse par rapport au coût d'exploration. Cela arrive typiquement après une baisse de trafic direct, après une chute de temps de réponse, ou après une explosion de pages minces et peu liées.
Tant que la Search Console ne signale pas d'erreur critique, il s'agit rarement d'une pénalité, mais d'un arbitrage budgétaire. Le levier concret reste la consolidation du contenu existant et la suppression des pages fantômes.
Combien de temps faut-il pour voir l'effet d'un changement technique ?
Google publie, dans sa documentation sur l'indexation, des délais de plusieurs jours à quelques semaines pour propager un changement. Sur un blog d'entreprise, prévoir 14 à 28 jours d'observation avant toute conclusion. Plus court que cela, vous mesurez du bruit.
Le sitemap est-il encore indispensable en 2026 ?
Oui, mais son rôle a changé : il sert désormais de carte de secours, pas de mode principal de découverte. Tant que le maillage interne reste cohérent, le sitemap sert surtout à signaler les pages orphelines ou nouvellement créées.
Un sitemap propre, avec lastmod honnêtement mis à jour, reste un signal positif ; un sitemap trompeur devient un signal négatif.
Le « crawl budget » est-il différent de la fréquence d'indexation ?
Ce sont deux notions proches mais distinctes.
- Le « crawl budget » désigne l'effort total que Google consent à dépenser sur un site, calculé en requêtes par seconde agrégées.
- La fréquence d'indexation désigne la cadence à laquelle de nouvelles pages passent du statut « détectées » au statut « explorées puis indexées ».
Une cadence élevée d'exploration n'entraîne pas mécaniquement plus d'indexation si la qualité du contenu ne suit pas.