
Jak pisać posty bloga pod AI Overviews w 2026
Właściciel sklepu, który od lat prowadzi blog SEO, zauważa dziś niepokojący wzorzec: ruch z Google powoli spada, a w odpowiedziach Google AI Overviews oraz w wynikach ChatGPT i Perplexity pojawiają się cytaty z domen konkurencji — czasem z artykułów gorszych jakościowo niż te, które sam opublikował. Jeśli zastanawiasz się, jak pisać pod AI Overviews w 2026 roku, to odpowiedź w jednym zdaniu brzmi: tworzyć artykuły, które da się zacytować, czyli z konkretną strukturą, weryfikowalnymi źródłami i jasnymi odpowiedziami na pytania, które ludzie naprawdę wpisują w wyszukiwarkę.
Poniżej znajdziesz pełną ścieżkę: od zrozumienia, czym jest cytowalność treści AI, przez audyt pojedynczego posta, aż po jednodniowy audyt całej biblioteki bloga. Dla właścicieli sklepów oznacza to tyle, że nawet bez wzrostu pozycji w klasycznych wynikach możesz odzyskać widoczność — ale tylko wtedy, gdy artykuły zaczną wyglądać jak źródła faktów, a nie jak silosy słów kluczowych.
Spis treści
- Najważniejsze wnioski
- Czym jest cytowalność treści w AI search i czym różni się od klasycznego SEO?
- Co sprawia, że model językowy cytuje dany artykuł, a nie konkurencję?
- Jak sprawdzić, czy Twoje obecne posty są cytowane przez AI (ChatGPT, Perplexity, Google AI Overviews)?
- Które elementy artykułu SEO najłatwiej podnieść pod cytowalność: struktura, źródła, dane, formatowanie?
- Checklist 10 punktów do audytu pojedynczego artykułu pod kątem cytowań AI
- Jak przeprowadzić taki audyt na całej bibliotece bloga sklepu w jeden dzień roboczy?
- Często zadawane pytania
- Źródła
Najważniejsze wnioski
- Cytowalność treści AI w 2026 to nie jest „magiczne SEO dla chatbota" — to zwykłe, dobre SEO wykonane w sposób, który modele językowe łatwo przetwarzają i wycinają jako cytat.
- Największą dźwignią jest struktura: krótka odpowiedź na początku, potem rozwinięcie, pytania jako nagłówki, lista źródeł, dane liczbowe z datą.
- Modele cytują artykuły, które wyglądają jak jednoznaczne źródło faktu, a nie jak silos słów kluczowych — czyli teksty z autorytetem tematycznym i weryfikowalnymi danymi.
- Audyt biblioteki bloga da się zrobić w jeden dzień roboczy, jeśli najpierw zdefiniujesz 8–10 pytań „people also ask" dla każdej kategorii i ocenisz posty według tej samej checklisty.
- Manualna optymalizacja setek postów jest realna dla małego bloga, ale przy bibliotekach powyżej kilkuset artykułów opłaca się najpierw ustalić rytm i priorytety, zanim zaczniesz przepisywać.
Czym jest cytowalność treści w AI search i czym różni się od klasycznego SEO?
Cytowalność treści AI to prawdopodobieństwo, że model językowy — czy to w Google AI Overviews, ChatGPT, Perplexity czy Claude — użyje zdania, akapitu lub listy z Twojego artykułu jako źródła dla odpowiedzi. W klasycznym SEO liczy się pozycja i kliknięcie; w AI search liczy się to, czy Twoje zdanie w ogóle trafi do odpowiedzi, często bez linku, po którym użytkownik mógłby kliknąć.
To dlatego optymalizacja pod AI Overviews w 2026 to przede wszystkim inżynieria cytatu, a nie pozycji. W klasycznym SEO walczysz o dziesiąte miejsce na liście wyników; w AI search walczysz o to, czyje zdanie model wklei do wygenerowanej odpowiedzi. Inny jest też miernik sukcesu — w klasyce liczysz kliknięcia i pozycje, w AI search liczysz wzmianki w odpowiedziach modelu.
Różnice są cztery i wszystkie wynikają z tego, że człowiek widzi listę linków, a model widzi listę zdań do zacytowania:
- Cel klasycznego SEO: kliknięcie. Cel AI search SEO 2026: bycie cytatem w generowanej odpowiedzi.
- Miernik klasyczny: pozycja, CTR, czas na stronie. Miernik nowy: liczba wzmianek w odpowiedziach AI, dokładność cytatu, widoczność marki.
- Format zwycięstwa w klasyce: meta title, featured snippet, rich result. Format zwycięstwa w AI: samodzielne zdanie-fakt z datą, autorem i źródłem.
- Ryzyko: w klasycznym SEO spadasz z pozycji. W AI search — cytuje Cię ktoś inny, a Ty nie dostajesz nawet ruchu.
W praktyce większość zasad się pokrywa: dobre nagłówki, czytelne akapity, dane, źródła. Zmienia się tylko to, co model „widzi" jako łatwe do skopiowania. Dlatego traktuj cytowalność nie jako osobny kanał, lecz jako kolejną warstwę rygoru na tym, co już robisz dobrze.
Co sprawia, że model językowy cytuje dany artykuł, a nie konkurencję?
Model językowy cytuje artykuł, który wygląda jak jednoznaczne, bezpieczne źródło faktu: zawiera już sformatowaną odpowiedź, kto to powiedział, kiedy i gdzie można to sprawdzić. Pisanie pod modele językowe sprowadza się więc do trzech decyzji redakcyjnych: wybierasz jedno pytanie na artykuł, odpowiadasz na nie w pierwszych 50 słowach i dorzucasz co najmniej jedno odwołanie do źródła pierwotnego, a nie do wtórnego.
To oznacza też konsekwencję w każdym fragmencie tekstu — model nie patrzy na cały artykuł jako całość, lecz wybiera najkrótszą jednostkę, która domyka myśl. Jeśli w jednym akapicie masz cztery rozwlekłe zdania, a w innym jedno krótkie z liczbą i datą, model wybierze to drugie.
Konkretne sygnały, które modele traktują jako „ten fragment da się zacytować":
- Lista kroków w formie numerowanej, z jednym krokiem = jedno zdanie, bez rozwlekłych wprowadzeń.
- Definicja w jednym zdaniu, wyrównana do pytania „Co to jest X?", w pierwszym akapicie.
- Cytat z nazwiskiem, stanowiskiem i datą, wyraźnie oddzielony od reszty tekstu.
- Tabela porównawcza z dwiema–czterema kolumnami i jedną liczbą w każdej komórce.
Rywalizujesz nie o uwagę modelu, lecz o to, czyje zdanie zostanie wybrane jako cytat. Jeśli Twoje zdanie jest dłuższe niż 40 słów, pełne przymiotników i pozbawione źródła — model wybierze cudze. To twarda reguła: cytowalne jest to, co da się wyciąć nożyczkami i wkleić do odpowiedzi bez edycji.
Jak sprawdzić, czy Twoje obecne posty są cytowane przez AI (ChatGPT, Perplexity, Google AI Overviews)?
Pierwszy krok audytu to ustalenie, które z Twoich postów w ogóle biorą udział w rozmowie, zanim zaczniesz cokolwiek poprawiać. Potrzebujesz trzech niezależnych punktów obserwacji: wyszukiwarki Google z włączonym AI Overviews, Perplexity i ChatGPT — każde z nich cytuje nieco inaczej i nie można sprawdzić cytowalności tylko w jednym z nich.
Audyt treści AI zaczyna się od dwudziestu pytań, które Twój kluczowy klient wpisałby w Google, i od przejrzenia odpowiedzi AI dla każdego z nich. Na tym etapie nie oceniasz jeszcze jakości artykułów — tylko sprawdzasz, które z nich w ogóle są widoczne dla modelu i w jakim kontekście padają.
Konkretna procedura wygląda tak:
- Wypisz 20–30 najważniejszych pytań w Twojej kategorii (te, które prowadzą do Twoich najlepszych stron produktowych).
- Dla każdego pytania otwórz Google z włączonym AI Overviews, wpisz pytanie dosłownie i zanotuj, czy Twoja domena pojawia się w cytowanych źródłach.
- To samo pytanie zadaj Perplexity (z włączonym trybem Pro, jeśli masz) i sprawdź, czy Twoja strona jest cytowana, a jeśli nie — czyja jest.
- W ChatGPT włącz wyszukiwanie, poproś o odpowiedź z przypisami i zweryfikuj, czy Twoja domena pada w źródłach.
- Wynik zapisz w prostym arkuszu: pytanie, cytowany URL, Twoja pozycja (cytowana/nie), model.
Dodaj kolumnę „źródło cytatu" — wklej dosłownie to zdanie z Twojego artykułu, które model wybrał, jeśli je zacytował, albo zapisz, że cytatu nie ma. Po przejściu 30 pytań zobaczysz wyraźny wzorzec: te same pięć–dziesięć artykułów, które mają sensowną strukturę, regularnie się przewijają, a pozostałe milczą. To są Twoi pretendenci do optymalizacji.
Które elementy artykułu SEO najłatwiej podnieść pod cytowalność: struktura, źródła, dane, formatowanie?
Największą dźwignię mają cztery elementy, a wszystkie są kwestią redakcji, nie technologii: pierwszy akapit z odpowiedzią, lista źródeł z datą, tabela porównawcza oraz nagłówki pytań. Przy artykule liczącym 1500 słów zmiana tych czterech elementów podnosi szansę cytatu bardziej niż przepisywanie całej treści.
Struktura artykułu pod AI zaczyna się od decyzji „czy to zdanie da się zacytować", a kończy na decyzji „czy autor może je podpisać". Między tymi dwoma decyzjami mieści się cała redakcja — od wyboru źródeł, przez format tabeli, po sposób prowadzenia nagłówków.
Zacznij od pierwszych 50 słów. Każdy post powinien odpowiadać na pytanie z tytułu w jednym akapicie, zanim pojawi się jakiekolwiek tło. Model wybiera cytat z tego, co widzi pierwsze — jeśli pierwsze 200 słów to dygresja o historii firmy, cytat trafia do konkurenta, któremu udało się zacząć od razu od odpowiedzi.
Drugi element to źródła. Wpisz w konwencję artykułu blok „Źródła" na końcu, w którym każda pozycja ma rok publikacji i klikalny link. Modele preferencują raporty z bieżącego lub ubiegłego roku, statystyki rządowe i dokumenty organów regulacyjnych.
Trzeci element to tabela. Jeśli porównujesz dwie–cztery opcje, zamień akapit na tabelę z dwiema–czterema kolumnami. Modele bardzo chętnie cytują tabele, bo komórka z liczbą jest najkrótszą możliwą jednostką cytatu.
Czwarty element to nagłówki w formie pytań. Co najmniej dwa–trzy H2 albo H3 w artykule powinny brzmieć jak pytanie, które ktoś mógłby wpisać w Google — na przykład „Jak długo przechowywać dane klientów?" albo „Ile kosztuje audyt treści pod AI?". Modele dopasowują nagłówki do pytań 1:1 i cytują odpowiedź, która znajduje się bezpośrednio pod nagłówkiem.
Dodatkowe, mniejsze dźwignie: wyróżniona na początku sekcja definicji („X to Y") w jednym zdaniu, daty w treści („stan na październik 2026") oraz autor z imieniem i nazwiskiem przy artykule.
Jak konkretnie wygląda „cytowalny" akapit?
Konkretny przepis jest taki: jedno zdanie, jedna myśl, jedna data i jedno źródło w tym samym zdaniu. To jest dokładnie ta sama informacja, ale jedna wersja wchodzi do modelu, a druga nie.
Dlaczego listy źródeł są ważniejsze niż backlinki?
Linki zwrotne pomagają pozycji w klasycznym SEO, ale w AI search model nie pobiera linku z Twojej strony — on cytuje stronę, która sama cytuje źródło pierwotne. Artykuł z 20 linkami do własnych kategorii produktowych i zera linków do źródeł zewnętrznych jest dla modelu mniej wartościowy niż artykuł, który cytuje pięć pierwotnych raportów z datą. Zmiana jest prosta: zamień połowę linków wewnętrznych na linki do źródeł pierwotnych i dodaj blok „Źródła" na końcu.
Jak często aktualizować daty przy danych?
Co najmniej raz na rok, a jeśli temat jest zmienny (podatki, regulacje, ceny) — co kwartał. Modele ważą datę: zdanie z 2022 roku jest dla nich mniej pewne niż zdanie z 2026, nawet jeśli treść się nie zmieniła. Dlatego przy każdej aktualizacji wystarczy często zmienić jedną liczbę lub dopisać rok w nagłówku — robot i tak to zauważy.
Checklist 10 punktów do audytu pojedynczego artykułu pod kątem cytowań AI
Audyt pojedynczego artykułu to 10 pytań, na które odpowiadasz „tak" lub „nie".
Punkt pierwszy dotyczy pierwszego akapitu — to on decyduje, czy model w ogóle rozważy Twój artykuł jako źródło. Punkt drugi to nagłówki w formie pytań, które dopasowują się do intencji wyszukiwania. Punkty trzeci i czwarty to lista i tabela, czyli formaty, które modele cytują najchętniej.
- Czy w pierwszych 50 słowach artykułu znajduje się kompletna odpowiedź na pytanie z tytułu?
- Czy co najmniej trzy nagłówki (H2 albo H3) brzmią jak pytanie, które użytkownik mógłby wpisać w Google?
- Czy artykuł zawiera co najmniej jedną tabelę lub listę numerowaną z krótkimi elementami?
- Czy jest blok „Źródła" z datą publikacji każdej pozycji i klikalnym linkiem?
- Czy w artykule są co najmniej trzy konkretne liczby z rokiem i źródłem w tym samym zdaniu?
- Czy jest wyraźnie oddzielony cytat z nazwiskiem, stanowiskiem i datą?
- Czy co najmniej jedna sekcja zaczyna się od definicji „X to Y" w jednym zdaniu?
- Czy w tekście są wskazane daty aktualizacji („stan na październik 2026")?
- Czy artykuł ma widocznego autora z imieniem i nazwiskiem oraz bio na końcu?
- Czy artykuł zawiera co najmniej jedno odwołanie do źródła pierwotnego (raport, regulacja, dane publiczne)?
Każde „tak" podnosi prawdopodobieństwo cytatu o przyrosty, które trudno zmierzyć w pojedynczym artykule, ale w bibliotece 100 postów sumują się w zauważalną różnicę w odpowiedziach AI.
Jak przeprowadzić taki audyt na całej bibliotece bloga sklepu w jeden dzień roboczy?
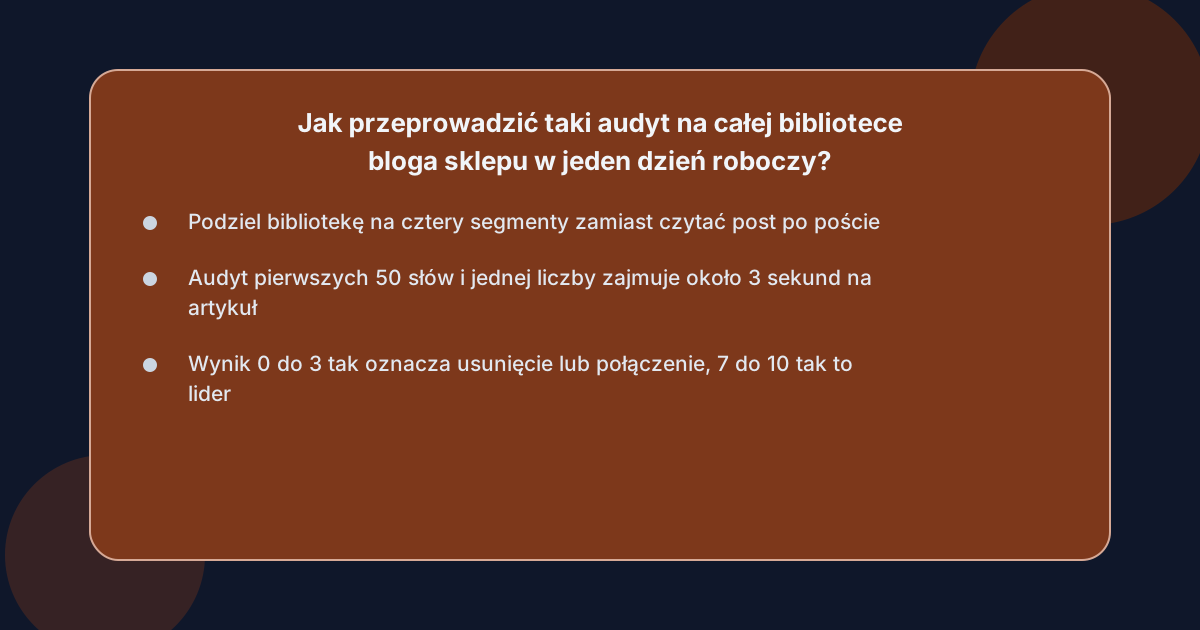 Audyt całej biblioteki w jeden dzień jest realny, jeśli zrezygnujesz z czytania każdego artykułu i podejdziesz do niego jak do operacji na danych. Zamiast otwierać 300 postów jeden po drugim, dzielisz bibliotekę na cztery segmenty, sortujesz po dacie publikacji i przepuszczasz każdy segment przez tę samą checklistę zautomatyzowaną w arkuszu.
Podejście „jeden dzień, cały blog" działa, ponieważ większość postów w sklepie to wariacje na temat tych samych pięciu–ośmiu intencji wyszukiwania: poradniki kategorii, porównania, listy, definicje, case studies. To pozwala traktować audyt jak powtarzalną procedurę, a nie jak indywidualną ocenę każdego tekstu.
Krok pierwszy: eksport. Pobierz z CMS-a tytuł, URL, datę publikacji, liczbę słów i kategorię dla każdego artykułu. Otwórz arkusz i zostaw tylko trzy kolumny: URL, data, „priorytet". Priorytet wyznaczasz ręcznie na podstawie ruchu z Google Search Console — top 20 artykułów to priorytet A, następne 50 to priorytet B, reszta to C.
Krok drugi: grupowanie. Pogrupuj artykuły po intencji (poradnik, porównanie, lista, definicja) i po dacie publikacji. Starsze niż 18 miesięcy trafiają do osobnej kolejki, bo wymagają odświeżenia dat, nawet jeśli treść jest dobra.
Krok trzeci: masowy audyt pierwszych 50 słów. Otwórz 100 artykułów priorytetu A i B i sprawdź tylko pierwszy akapit oraz jedną liczbę w treści. Wpisz w arkuszu „odpowiedź w pierwszych 50 słowach: tak/nie" oraz „czy jest liczba z rokiem: tak/nie". To zajmuje około 3 sekund na artykuł, więc 100 postów mieści się w 5–7 minutach z marginesem.
Krok czwarty: segmentacja po checklist. W arkuszu dodaj kolumny dla każdego punktu checklisty (10 kolumn, tak/nie). Priorytet A wypełniasz w pełni, priorytet B tylko pod kątem punktów 1, 2 i 5, priorytet C oznaczasz „do konsolidacji lub usunięcia".
Krok piąty: decyzja. Artykuły z wynikiem 0–3 tak to kandydaci do usunięcia lub połączenia z innym postem. Artykuły z wynikiem 4–6 tak to porządni kandydaci do odświeżenia — zwykle wystarczy poprawić pierwszy akapit, dodać jedną tabelę i aktualizację dat. Artykuły z wynikiem 7–10 tak to Twoi obecni liderzy i warto zadbać, żeby nic w nich nie zepsuć.
Ten podział zmienia też pytanie „kto to zrobi". Sam możesz w jeden dzień przejść 200–300 artykułów w trybie „audyt, nie redakcja" — bez przepisywania. Przepisywanie zostawiasz na priorytet A, czyli 15–30 postów, które naprawdę warto otworzyć w edytorze.
Właśnie w tym miejscu pojawia się decyzja o tym, jak automatyzować taką pracę na blogu sklepu: w małej bibliotece (do 100 postów) wystarczy arkusz i weekend; w średniej (200–600 postów) warto mieć stały rytm audytu co kwartał; w dużej bibliotece (powyżej 1000) pojawia się pytanie, czy ręczne przepisywanie liderów skaluje się z czasem, czy lepiej zaplanować publikację artykułów z audytem wbudowanym w rytm. Na większą skalę warto rozważyć narzędzia, które łączą planowanie treści, generowanie i publikację na własnej domenie, bo wtedy każdy nowy artykuł od początku spełnia checklistę, a nie wymaga poprawiania po fakcie.
W tym miejscu warto wymienić xt4b, które generuje artykuły i publikuje je bezpośrednio na blogu działającym na Twojej domenie, dzięki czemu każdy post startuje od razu ze strukturą pisaną pod cytowalność, a nie pod klasyczną pozycję. Narzędzie ma sens, jeśli prowadzisz blog regularnie i chcesz, żeby standard cytowalności był wbudowany w proces, a nie dorzucany ręcznie przy każdym starszym tekście; nie zastąpi ono natomiast decyzji redakcyjnej o tym, które tematy w ogóle warto poruszać, bo to po stronie właściciela sklepu pozostaje zarówno strategia kategorii, jak i rytm publikacji.
Często zadawane pytania
Czy optymalizacja pod AI Overviews różni się od optymalizacji pod klasyczne SEO?
W klasycznym SEO liczy się pozycja i kliknięcie, a w AI Overviews liczy się to, czy Twoje zdanie trafi do cytatu w generowanej odpowiedzi. Wspólne są: dobra struktura, czytelne nagłówki, dane i źródła. Różnica polega na tym, że w AI search wygrywasz krótkim, samodzielnym zdaniem z liczbą, datą i źródłem, a nie wpisem z meta title i długim wstępem.
Jak często modele językowe aktualizują swoje źródła?
Nie ma jednego cyklu — zależy to od modelu i od wyszukiwarki, z której korzysta. Google AI Overviews cytuje strony, które dobrze indeksuje, więc częstotliwość odświeżania treści wpływa pośrednio. Perplexity i ChatGPT z włączonym wyszukiwaniem cytują strony na bieżąco, ale preferują te z datą publikacji lub aktualizacji z bieżącego roku. W praktyce artykuł zaktualizowany w 2026 ma większą szansę na cytat niż artykuł z 2023 z dokładnie tą samą treścią.
Ile czasu zajmuje przepisanie jednego artykułu pod cytowalność?
Od 30 do 90 minut dla artykułu liczącego 1200–1800 słów, jeśli treść jest merytorycznie poprawna. Najczęściej poprawiasz tylko pierwszy akapit, dodajesz jedną tabelę, aktualizujesz daty i dorzucasz blok źródeł. Przepisywanie od zera to już godziny, dlatego lepiej najpierw przejść audyt i poprawiać to, co jest, niż pisać nowe wersje.
Czy schema markup pomaga w cytowalności przez AI?
Pomaga, ale nie jest warunkiem wystarczającym. Schema Article i FAQPage zwiększają szansę, że crawler lepiej zrozumie strukturę strony, ale cytat i tak wybiera model na podstawie treści. W praktyce najpierw popraw strukturę i źródła, a schema dodawaj na końcu, kiedy treść już jest cytowalna.
Jak mierzyć, czy artykuł jest cytowany przez AI, jeśli ChatGPT nie pokazuje statystyk?
Najprościej: regularnie wpisuj w Google z włączonym AI Overviews, w Perplexity i w ChatGPT pytania z Twojej kategorii i ręcznie sprawdzaj, czy Twoja domena pada w odpowiedziach. Do śledzenia w czasie wystarczy arkusz z pytaniem, datą sprawdzenia i kolumną „cytowany: tak/nie". Przy 30 pytaniach sprawdzanych co miesiąc masz miarę trendu, nawet bez dedykowanego narzędzia.