Schema markup dla bloga SEO: jak zacząć
Schema markup dla bloga SEO pomaga Google lepiej zrozumieć treść artykułu i może zwiększyć szansę na bogatszy wynik wyszukiwania. W praktyce najważniejsze są poprawne dane strukturalne, zgodność z widoczną treścią oraz testowanie wdrożenia. Poniżej znajdziesz praktyczny opis najczęstszych typów oznaczeń, instrukcję ich dodawania i listę narzędzi do weryfikacji.
Spis treści
- Najważniejsze wnioski
- Czym jest Schema markup w SEO i dlaczego blog go potrzebuje?
- Które typy Schema najlepiej sprawdzają się na blogu?
- Jak dodać Schema markup do artykułu krok po kroku?
- Jak sprawdzić, czy Schema markup jest poprawnie wdrożony?
- Czy Schema markup zastąpije dobre treści SEO?
- Często zadawane pytania
- Źródła
Najważniejsze wnioski
- Najczęściej stosowanym typem oznaczenia artykułu blogowego jest
BlogPosting, uzupełniany danymi autora, obrazem, datą publikacji i informacją o publikatorze. - Dane strukturalne powinny opisywać wyłącznie treść widoczną na stronie — niezgodne informacje mogą wprowadzić wyszukiwarkę w błąd.
- Do treści na blogu najczęściej wybiera się
Article,BlogPosting,FAQPageoraz, jeśli to zasadne,BreadcrumbList. - Najbezpieczniejszym formatem implementacji jest JSON-LD, umieszczany w bloku
<script>. - Poprawność oznaczeń należy sprawdzać narzędziami Google, Rich Results Test i Schema Markup Validator.
Czym jest Schema markup w SEO i dlaczego blog go potrzebuje?
Schema markup w SEO to standard oznaczania treści danymi strukturalnymi, które opisują ich meaning i relacje między elementami strony. Dzięki niemu roboty wyszukiwarek mogą rozpoznać artykuł, autora, pytania i odpowiedzi, breadcrumbs czy dane organizacji.
Dane strukturalne nie są jednak zamiennikiem treści. Opisują informacje już zamieszczone w artykule, pomagając Google zinterpretować ich znaczenie i zdecydować, czy mogą wyświetlić je w rozszerzonym wyniku wyszukiwania.
Schema markup dla bloga SEO przynosi największą korzyść, gdy:
- opisuje typ strony i główny temat artykułu;
- wskazuje autora, datę publikacji i ewentualną aktualizację;
- identyfikuje obrazy główne i organizację publikującą;
- porządkuje nawigację strony;
- ujawnia pytania i odpowiedzi obecne w treści;
- ułatwia zrozumienie relacji między artykułami, kategoriami i autorami.
Czy dane strukturalne zwiększają pozycję w Google?
Dane strukturalne nie są bezpośrednim czynnikiem rankingowym, ale mogą ułatwiać zrozumienie strony i wpływać na sposób jej prezentacji w wynikach wyszukiwania. Google nie obiecuje jednak rozszerzonego wyniku wyłącznie dlatego, że kod jest poprawny.
Google może wyświetlić dodatkowe informacje, takie jak okładka artykułu, autor, daty lub zwinięte pytania i odpowiedzi. Kolejność i obecność takich elementów zależą od zapytania, jakości strony i dostępności danych.
Praktyczną zasadą jest: najpierw wartość treści, potem oznaczenia. Pomocny przegląd jakości i luk treściowych znajdziesz w ramach audytu zawartości SEO.
Które typy Schema najlepiej sprawdzają się na blogu?
Dla typowego artykułu blogowego najważniejsze jest oznaczenie BlogPosting, natomiast Article może opisywać treści o bardziej uniwersalnym charakterze. Właściwy dobór zależy od rodzaju strony, a nie od popularności samego typu.
Kiedy wybrać BlogPosting schema?
BlogPosting najlepiej pasuje do artykułu publikowanego na blogu, w którym można wskazać autora, redaktora, datę publikacji, obraz i organizację. Ten typ danych strukturalnych jest odpowiedni dla poradników, analiz, recenzji i artykułów eksperckich.
Przykładowy szkielet JSON-LD może obejmować:
@context:https://schema.org;@type:BlogPosting;headline: tytuł artykułu;description: krótki opis treści;datePublished: data publikacji;dateModified: data aktualizacji, jeżeli artykuł był zmieniany;author: osoba lub organizacja odpowiedzialna za treść;publisher: organizacja publikująca;image: adres obrazu głównego;mainEntityOfPage: adres artykułu.
Wartości należy przenosić bezpośrednio z artykułu. Jeśli tytuł widoczny na stronie brzmi inaczej niż headline, lepiej je ujednolicić.
Kiedy użyć FAQPage schema?
FAQPage opisuje stronę zawierającą pytania i odpowiedzi. Tego typu nie należy używać wyłącznie po to, aby wygenerować rozszerzony wynik — pytania muszą rzeczywiście występować w widocznej treści.
W strukturze FAQPage warto wskazać:
mainEntity;- listę pytań jako
Question; - odpowiedź jako
AcceptedAnswerz właściwościątext.
Najlepiej wykorzystać FAQPage na stronie poświęconej częstym pytaniom, a nie automatycznie dodawać ten typ do każdego artykułu. Nadmiar oznaczeń niezwiązanych z zawartością może utrudniać utrzymanie zgodności.
Jakie znaczenie mają breadcrumbs?
BreadcrumbList opisuje ścieżkę nawigacji prowadzącą do artykułu, na przykład: strona główna, kategoria, podkategoria i wpis. Pomaga to Google zrozumieć strukturę serwisu i sposób klasyfikacji treści.
Breadcrumbs w JSON-LD powinny odpowiadać widocznym linkom na stronie. Jeśli blog nie pokazuje takiej ścieżki, dodanie samego znacznika bez odpowiadającej mu nawigacji nie przyniesie pożadku.
Czy Organization i Person są potrzebne?
Organization jest przydatna, gdy chcesz jednoznacznie wskazać firmę, jej logo, stronę internetową i kontakty. Typ Person może opisywać autora lub eksperta. Oznaczenia te wspierają zrozumienie podmiotów występujących w artykule, choć ich wpływ na widoczność zależy od całego profilu witryny.
Jeżeli autorzy publikują regularnie, warto zadbać o spójne profile osób, prawidłowe powiązanie autora z treścią i osobne strony prezentujące ich doświadczenie. Schemat strony autora powinien być zgodny z faktycznie dostępnymi informacjami.
Jak dodać Schema markup do artykułu krok po kroku?
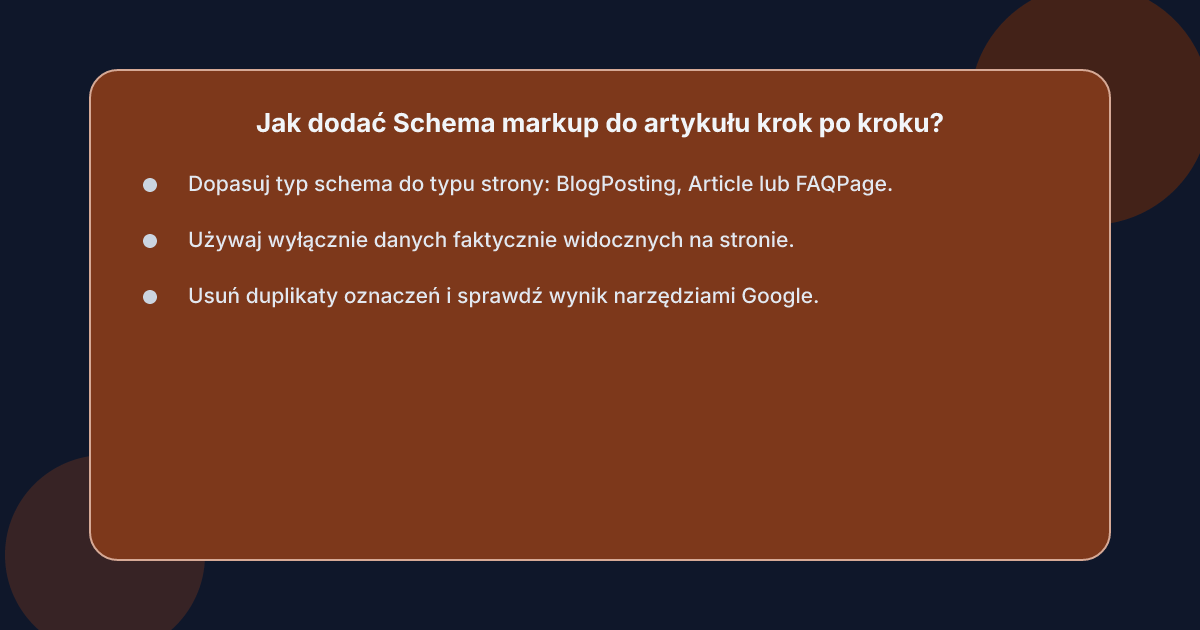 Najprostszym sposobem jest ręczne dodanie kodu JSON-LD w kodzie artykułu albo skonfigurowanie odpowiedniego rozszerzenia w WordPressie. W obu przypadkach trzeba zacząć od ustalenia typu strony, przygotowania wartości i dopasowania oznaczeń do treści.
Krok 1: ustal typ strony
Najpierw wybierz typ odpowiadający funkcji artykułu. Dla typowego wpisu na blogu będzie to zwykle BlogPosting; dla treści wywiadu lub materiału bez cech publikacji blogowej możliwy jest Article.
Warto sprawdzić, czy wybrany typ jest właściwy dla strony:
- czy artykuł rzeczywiście ma datę publikacji i autora;
- czy autor jest osobą, czy organizacją;
- czy istnieje jeden główny obraz;
- czy treść zawiera FAQ, jeśli planujesz użyć
FAQPage; - czy breadcrumbs są widoczne dla użytkownika.
Krok 2: przygotuj JSON-LD dla bloga
JSON-LD dla bloga zapisuje się jako obiekt JavaScript umieszczony w znaczniku <script>. Minimalny szkielet wygląda następująco:
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Tytuł artykułu",
  "description": "Opis artykułu",
  "datePublished": "2026-10-20",
  "dateModified": "2026-10-25",
  "author": {
    "@type": "Person",
    "name": "Imię i nazwisko autora"
  },
  "image": [
    "https://
  ],
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": "https://
  }
}
Przykład pokazuje jedynie strukturę. Każdą wartość trzeba zastąpić danymi faktycznie obecnymi na konkretnej stronie.
Krok 3: dopasuj dane do widocznej treści
Najważniejsza zasada: oznaczenie ma odzwierciedlać treść, a nie dostarczać informacji niewidocznych dla czytelnika. Tytuł, opis, data, autor, obraz i treść FAQ powinny być zgodne z tym, co faktycznie znajduje się na stronie.
Nie dodawaj:
- fałszywych ocen lub liczby recenzji;
- niewidocznych odpowiedzi wygenerowanych tylko dla wyszukiwarki;
- daty publikacji, której strona nie prezentuje;
- autora powiązanego z innym materiałem;
- identyfikatora organizacji niewystępującego w publikacji.
Jeśli artykuł był aktualizowany, data modyfikacji powinna odpowiadać rzeczywistej, widocznej informacji. Przy braku takiej informacji lepiej jej nie wymyślać.
Krok 4: dodaj kod do szablonu artykułu
W WordPressie kod może zostać dodany bezpośrednio w szablonie pojedynczego wpisu albo za pośrednictwem wtyczki lub funkcji motywu. Jeśli korzystasz z gotowego rozszerzenia do schema markup WordPress, sprawdź, czy umożliwia ustawienie BlogPosting, a nie tylko ogólnego Article.
Praktyczne podejście wygląda następująco:
- Dodaj dane strukturalne do szablonu lub rozszerzenia.
- Uzupełnij dane dynamiczne, takie jak tytuł, autor i adres.
- Ustaw obraz główny jako element
image. - Nie umieszczaj kilku konfliktujących typów opisujących tę samą stronę.
- Usuń stare oznaczenia po migracji lub zmianie motywu.
Jeśli wdrażasz oznaczenia w dużej skali, warto prowadzić rejestr każdego typu strony: szablon, wtyczka, źródło danych i osoba odpowiedzialna. Pomaga to wykryć duplikaty podczas aktualizacji.
Krok 5: wygeneruj FAQ i breadcrumbs
Pytania i odpowiedzi należy najpierw umieścić w artykule jako normalną treść. Następnie można odwzorować je w FAQPage.
Przykładowa pojedyncza para:
{
  "@type": "Question",
  "name": "Jak sprawdzić poprawność danych strukturalnych?",
  "acceptedAnswer": {
    "@type": "Answer",
    "text": "Najpierw sprawdź kod w narzędziu Rich Results Test, a następnie zweryfikuj dane w Schema Markup Validator."
  }
}
Nie należy dodawać w obiekcie FAQPage pytań, których nie ma na stronie. Oznaczenie FAQ nie zastępuje sekcji pytań i odpowiedzi — jedynie je opisuje.
Krok 6: usuń duplikaty i sprawdź dane wyjściowe
Przed publikacją sprawdź źródło strony pod kątem kilku oznaczeń tego samego typu. Takie duplikaty mogą wynikać z rozszerzenia, motywu i ręcznie dodanego kodu.
Wyszukiwarka w kodzie strony powinna znaleźć jeden logiczny zestaw danych dla artykułu. Jeśli system generuje osobne fragmenty dla panelu breadcrumbs, organizacji i wpisu, sprawdź, czy każdy z nich opisuje odrębny element strony i czy nie powtarza tych samych właściwości.
Jak sprawdzić, czy Schema markup jest poprawnie wdrożony?
Poprawność Schema markup sprawdza się etapami: najpierw na czytelnej stronie, potem w narzędziach do walidacji, a następnie w wynikach testu rozszerzonych i danych indeksowanych. Sam brak błędów nie gwarantuje jednak wyświetlenia rozszerzonego wyniku.
Od jakich narzędzi zacząć?
Google Rich Results Test sprawdza, czy Google może wykorzystać oznaczenia do rozszerzonych wyników. Schema Markup Validator porównuje dane ze słownikiem schema.org i wskazuje błędy składniowe lub semantyczne.
Kolejność testowania:
- Otwórz adres artykułu w Rich Results Test.
- Uruchom test i sprawdź dostępne typy rozszerzonych wyników.
- Przejdź do Schema Markup Validator.
- Porównaj zgłoszone błędy i ostrzeżenia.
- Popraw dane w źródle, a nie tylko w wersji testowej.
- Wdróż zmianę i wykonaj test ponownie.
Testowanie schema markup najlepiej przeprowadzać na publicznie dostępnej wersji strony. Narzędzia analizują wersję po opublikowaniu, dlatego kod dodany wyłącznie w edytorze nie zostanie sprawdzony.
Jakie błędy najczęściej wskazują narzędzia?
Najczęstsze problemy obejmują:
- brak wymaganych właściwości;
- niedozwolone typy danych;
- daty w niewłaściwym formacie;
- tekst opisu, który nie odpowiada treści;
- nieistniejący lub niedostępny obraz;
- adres wskazujący inną stronę niż recenzowany artykuł;
- pytania z FAQPage, których nie ma w treści;
- niespójne dane autora, organizacji i publikatora;
- kilka konfliktujących oznaczeń na tej samej stronie.
Nie każde ostrzeżenie oznacza błąd krytyczny. Ważniejsze jest zrozumienie, czy komunikat dotyczy właściwości wymaganej przez konkretny typ i czy dane są zgodne z treścią.
Czy test w narzędziu Search Console wystarczy?
Nie. Search Console pokazuje dane o stronach, które Google zindeksował, w tym ewentualne błędy oznaczeń strukturalnych. Nie zastępuje jednak testu pojedynczego artykułu przed publikacją.
Najlepsza praktyka obejmuje:
- testowanie walidatorów przed publikacją;
- kontrolę adresów w Search Console po indeksowaniu;
- obserwację wyników po aktualizacji;
- porównywanie oznaczeń z wersją kanoniczną strony.
Warto pamiętać, że narzędzia ewaluują strukturę, ale nie oceniają całkowiciej jakości artykułu, wiarygodności autora ani dopasowania treści do intencji użytkownika. Pomocny blog może stanowić miejsce dla osobnych wyjaśnień dotyczących strategii treściowej.
Kiedy warto testować ręcznie?
Test ręczny jest potrzebny wtedy, gdy strona korzysta z JavaScriptu, treść jest ładowana dynamicznie albo renderowanie różni się między robotem a użytkownikiem. Warto wtedy porównać kod źródłowy z tym, co faktycznie renderuje przeglądarka.
Jeżeli organizacja regularnie publikuje dużą liczbę artykułów, ręczne testowanie każdej strony szybko staje się kosztowne. W takim procesie lepiej zautomatyzować wykrywanie duplikatów, brakujących właściwości i rozbieżności między treścią a oznaczeniami.
Czy warto zlecić wdrożenie freelancerowi lub agencji?
Wdrożenie pojedynczego typu oznaczeń zwykle nie wymaga rozbudowanego projektu, ale przy wielu szablonach, wtyczkach i danych z kilku źródeł potrzebna jest spójna strategia. xt4b automatyzuje analizę luk w wyszukiwaniu, planowanie, pisanie, kontrolę i publikację treści SEO na domenie klienta; nie jest przeznaczony dla osób potrzebujących jednorazowej, rozbudowanej implementacji schema.org w istniejącym systemie.
Kiedy wdrożenie danych strukturalnych jest nieodpowiednie?
Nie warto dodawać oznaczeń tylko dlatego, że są popularne. Jeśli strona nie jest artykułem, nie zawiera FAQ albo nie pokazuje breadcrumbs, odpowiedni typ danych strukturalnych nie będzie dla niej uzasadniony.
Dane strukturalne powinny rozwiązywać konkretny problem: opisywać treść, ułatwiać klasyfikację albo wskazywać relacje. Jeżeli ich jedynym rezultatem jest dłuższy kod strony, warto wrócić do treści i jej jakości.
Czy Schema markup zastąpije dobre treści SEO?
Schema markup nie zastąpi dobrych treści SEO, ponieważ opisuje treść, ale jej nie tworzy. Wartościowe, oryginalne i dopasowane do intencji wyszukiwania materiały nadal stanowią podstawę widoczności strony w Google.
Dane strukturalne działają jak dodatkowa warstwa informacji. Ułatwiają rozpoznanie artykułu, autora, pytań i nawigacji, lecz nie gwarantują pozycji, kliknięcia ani rozszerzonego wyniku.
Co daje Schema markup?
Najbardziej mierzalne korzyści obejmują:
- precyzyjniejsze rozpoznanie rodzaju strony;
- poprawne wyświetlanie dat i informacji o autorze;
- dostępność rozszerzonych wyników w odpowiednich zapytaniach;
- lepsze zrozumienie struktury publikacji;
- spójne dane między artykułami i innymi podstronami;
- możliwość wykrywania błędów przed indeksowaniem.
Dane strukturalne mogą ułatwić zrozumienie strony również innym systemom, jednak nie należy oczekiwać, że automatycznie zwiększą ruch lub sprzedaż. Efekt zależy od jakości publikacji, konkurencji, technicznego działania witryny i decyzji wyszukiwarki.
Jakie treści nadal mają największe znaczenie?
SEO nadal wymaga odpowiedzi na pytanie użytkownika, wartościowego materiału i dostępnej prezentacji. Artykuł powinien odpowiadać na konkretną intencję, wykorzystywać logiczną strukturę i opierać się na wiarygodnych informacjach.
Przed dodaniem schema markup warto zadać kilka pytań:
- Czy tytuł jasno opisuje temat?
- Czy tekst odpowiada na pytania czytelnika?
- Czy autor i źródła budują zaufanie?
- Czy nagłówki ułatwiają nawigację?
- Czy treść jest aktualna?
- Czy oznaczenia odzwierciedlają to, co faktycznie widać na stronie?
Jaki jest najlepszy kolejny krok?
Najpierw wskaż jeden typ strony, np. artykuł blogowy, i przygotuj dla niego komplet danych. Następnie zweryfikuj kod w dwóch walidatorach i porównaj go z treścią artykułu.
Dopiero po ustaleniu poprawnego wzorca można przenosić go na kolejne publikacje. Takie podejście ogranicza błędy, ułatwia aktualizacje i sprawia, że dane strukturalne rzeczywiście odzwierciedlająją zawartość bloga.
Często zadawane pytania
Czy Schema markup jest wymagany do pozycjonowania?
Nie, Schema markup nie jest wymagany do indeksowania ani rankingu strony. Jest jednak zalecany, ponieważ pomaga robotom interpretować treść i może umożliwić wyświetlenie rozszerzonego wyniku, jeśli strona spełnia pozostałe warunki.
Czy lepiej używać JSON-LD, HTML czy mikrodanych?
JSON-LD jest zwykle najprostszym i najczystszym formatem, ponieważ oddziela dane strukturalne od kodu HTML. Mikrodania mogą być wygodne przy prostych stronach, ale zwiększają ryzyko pomieszania treści wizualnej z oznaczeniami.
Jaki typ Schema wybrać dla artykułu blogowego?
Dla typowego wpisu na blogu najczęściej właściwy jest BlogPosting. Jeżeli strona nie ma wyraźnych cech bloga, można rozważyć bardziej ogólny Article, dopasowując komplet właściwości do wybranego typu.
Czy dodanie FAQPage gwarantuje rozszerzony wynik?
Nie. Google może wyświetlić FAQ tylko wtedy, gdy pytania i odpowiedzi są widoczne na stronie, dane są poprawne, a treść spełnia kryteria jakości i intencji wyszukiwania. Sam znacznik nie gwarantuje efektu.
Jak często należy aktualizować dane strukturalne?
Dane należy aktualizować wtedy, gdy zmienia się artykuł, tytuł, autor, data, obraz, treść FAQ albo struktura nawigacji. Po wdrożeniu warto okresowo sprawdzać duplikaty oraz rozbieżności między oznaczeniami a treścią.